26 septembre 2026Français
PeerDAS : le chat ninja ne télécharge pas le bloc entier
Le 26 septembre 2026, Vitalik Buterin a écrit quelque chose qui a été lu vite et peu discuté :
It’s an underappreciated triumph of Ethereum client developers that PeerDAS has now been running for nearly a year with basically no problems. PeerDAS was a complex task: it’s the first large-scale instance of a blockchain that achieves consensus on the availability of data without needing any single node to download the entire block. Decentralized consensus without replication. And yet, it worked.
Deux affirmations dans un seul tweet : que ça tournait depuis presque un an, et que ça n’avait pas posé de problème. Les deux sont vraies, et les deux cachent quelque chose de plus intéressant que ce qu’elles disent. Car ce qui a tenu, ce n’est pas la mathématique — elle était déjà écrite, relue et publiée — et ce qui a cédé en chemin, ce n’est pas PeerDAS. L’histoire de cette année est celle d’un protocole qui a enlevé un poids des épaules de dix mille nœuds et l’a laissé entier sur un seul.
Le poids des données
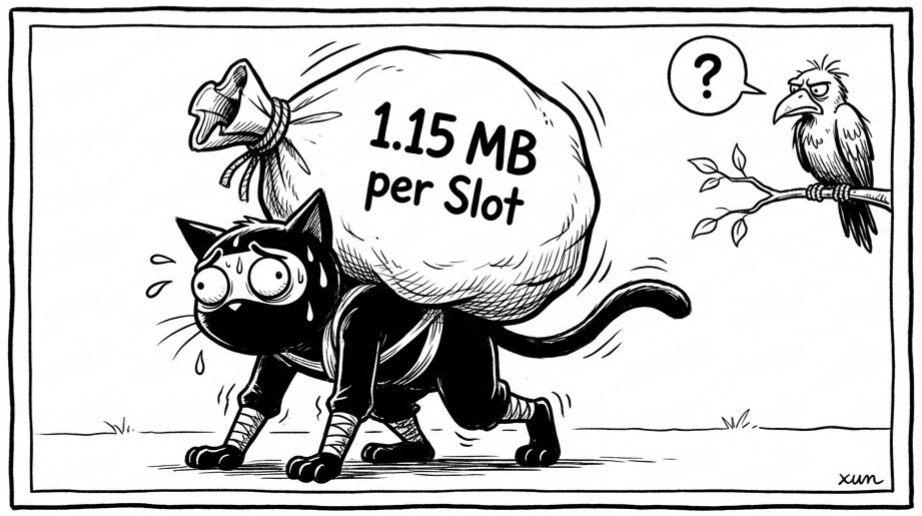
Commençons par le problème, parce que sans le problème l’astuce n’a aucun sens. Les rollups envoient des données à Ethereum dans des paquets appelés blobs, de 128 Kio chacun. Toutes les 12 secondes, un nouveau bloc. Avec les paramètres d’avant Fusaka — ceux de Pectra, 6 blobs de cible et 9 de plafond — c’était déjà plus de 1 Mo par slot dès que le réseau utilisait tout l’espace disponible.
Avant PeerDAS, chaque nœud téléchargeait tout. Et voilà le piège : la décentralisation ne se perd pas dans une attaque, elle se perd dans l’arithmétique. Si l’exigence minimale pour vérifier la chaîne grandit sans plafond, l’ensemble des gens capables de vérifier la chaîne rétrécit sans plafond. Obliger chaque nœud à tout porter est la façon la plus élégante de tuer la décentralisation : ça ne l’interdit pas, ça la rend chère.
Le pari : diviser le travail
PeerDAS (Peer Data Availability Sampling) est la réponse, et elle est arrivée sur le mainnet avec Fusaka le 3 décembre 2025, au slot 13 164 544. L’idée tient en une phrase : les nœuds cessent de télécharger le fichier entier et garantissent mathématiquement que les données existent en n’en portant qu’une fraction microscopique.
Il vaut la peine de le dire précisément, parce que ça ressemble à de la magie : ce n’est pas que les nœuds fassent confiance à quelqu’un qui, lui, a bien tout. C’est qu’ils peuvent prouver que le tout est là sans l’avoir vu. La division décentralisée du travail, appliquée à la disponibilité des données.
Étape 1 : la tranche holographique
Avant de distribuer quoi que ce soit, le bloc est étiré mathématiquement par codage Reed-Solomon : les données sont doublées (extension 2×). Et là apparaît l’astuce : si vous détenez n’importe quels 50 % des morceaux dispersés, vous pouvez reconstruire 100 % de la donnée d’origine.
Ce n’est pas une copie de sauvegarde. C’est un hologramme : chaque fragment contient de l’information sur le tout, et c’est pour ça qu’aucun n’a besoin d’être complet.
Étape 2 : 128 colonnes
Le blob étendu n’est pas distribué au hasard. Il est structuré en exactement 128 colonnes verticales, et ces colonnes deviennent la nouvelle unité de données fondamentale du réseau. Tout ce qui suit — garde, échantillonnage, sous-réseaux — se pense en colonnes.
Étape 3 : capter une fréquence
Le réseau se divise en sous-réseaux de colonnes, et un nœud domestique n’écoute pas le réseau entier. Il s’abonne à un sous-ensemble aléatoire et permanent (huit colonnes sur 128, par exemple) dérivé de son propre Node ID.
Que ce soit permanent compte plus qu’il n’y paraît : la garde n’est pas un choix que le nœud refait à chaque slot, c’est une position qui lui revient par son identité. Personne ne peut choisir de ne garder que ce qui l’arrange.
Étape 4 : la dégustation probabiliste
Ici se trouve le saut épistémique de toute la conception. Il n’est pas nécessaire de boire cinquante litres de soupe pour savoir si elle est salée.
Les nœuds demandent des échantillons aléatoires, minuscules, dans les colonnes des autres. Et pour avoir goûté quelques gouttes au hasard, ils obtiennent la certitude statistique que le blob entier est disponible. La sécurité ne vient pas de la couverture totale, elle vient de ce qu’un mensonge devrait survivre simultanément à chaque échantillon aléatoire que n’importe quel nœud décide de demander. C’est un pari — un très bon pari — sur la probabilité comme fondement.
Étape 5 : le sceau cryptographique de la vérité
Et c’est ici que l’échantillonnage devient fiable plutôt que naïf : les preuves KZG de cellule permettent à n’importe quel nœud de vérifier instantanément l’échantillon d’un pair, en le confrontant à l’engagement mathématique du bloc principal. Le nœud n’a jamais à faire confiance au pair qui lui sert les données.
L’échantillonnage sans vérification, c’est la foi. L’échantillonnage avec vérification, c’est la preuve. Entre les deux, il y a un engagement cryptographique qui attache chaque cellule au bloc, et qui permet d’accepter des données venant d’un ennemi.
Le filet de sécurité des supernœuds
Il reste un trou, et il vaut la peine de le nommer, parce que le titre « consensus décentralisé sans réplication » le recouvre. Pendant que les nœuds domestiques échantillonnent une fraction, les validateurs avec 4 096 ETH ou plus agissent comme des supernœuds : ils gardent les 128 colonnes complètes et constituent la colonne vertébrale qui garantit que la reconstruction est toujours possible.
Traduit : les petits nœuds échantillonnent, les gros archivent. PeerDAS n’a pas supprimé le nœud complet — il l’a rendu optionnel pour presque tous et obligatoire pour quelques-uns, et ces quelques-uns sont ceux qui ont le plus de capital. C’est un échange raisonnable, et il est infiniment meilleur que le monde d’avant, où l’obligation pesait sur tout le monde. Mais c’est un échange, pas un cadeau.
Ce que PeerDAS ne fragmente pas
Voici la partie que l’annonce ne dit pas, et c’est elle qui fait de cette année un début plutôt qu’une fin.
La vérification de la couche de consensus a été fragmentée horizontalement : c’est PeerDAS. Mais le blobpool de la couche d’exécution ne l’est pas — les nœuds téléchargent encore les blobs complets au moment où ils sont soumis — et surtout, le proposeur du bloc reste un seul nœud qui doit :
- étendre le blob avec le codage Reed-Solomon,
- calculer toutes les preuves KZG de cellule,
- et répartir les 128 colonnes sur le réseau,
tout cela avant la deadline d’attestation, quatre secondes après le début du slot. S’il n’y arrive pas, il perd le bloc ou se le fait réorganiser.
Le travail de vérifier s’est réparti sur des milliers. Le travail de publier reste entier sur un seul. Le goulot d’étranglement n’a pas disparu : il est passé de la bande passante au chemin critique du proposeur.
Et cela cesse d’être de la théorie dès qu’on mesure. Une analyse de Chainbound a montré que plus de blobs par bloc est corrélé à une pire latence de validation bloc+blob, un taux d’attestation plus faible et plus d’orphelins, et en a tiré une conclusion inconfortable et précise : dans un PBS qui se dispute la latence, cela peut imposer un plafond de blobs artificiel, en dessous de la limite que le protocole tolérerait. Sur le devnet de 60 nœuds qu’a fait tourner Optimism, ils sont arrivés à environ 50 blobs par bloc et c’est là que la fissure est apparue : retards de consensus accumulés, téléchargement des blobs devenu peu fiable et quelques supernœuds qui commençaient à lâcher.
Ce n’est pas que PeerDAS ne passe pas à l’échelle. C’est qu’il a mis à l’échelle la moitié du problème, et l’autre moitié — exécution, proposition, mempool — attend encore son propre PeerDAS.
L’embouteillage qui reste
Le second front ouvert est moins visible et plus urgent : le blobpool, le mempool de blobs de la couche d’exécution. Quand un rollup envoie un blob, les nœuds le téléchargent encore en entier avant qu’il ne devienne disponible sur le réseau. La vérification de disponibilité est désormais horizontale, mais la propagation de l’entrée reste verticale, et cela ouvre une vulnérabilité de déni de service très concrète : on peut inonder le réseau de blobs poubelles et faire payer à chaque nœud le coût de les télécharger tous, un par un.
La solution a un nom — le vertical sharding — et elle n’est pas encore là. PeerDAS a réglé le problème à la sortie ; l’entrée attend toujours.
Le bouton qui n’a pas besoin de hard fork
Le deuxième coup sous-estimé relève de la conception, et il est presque plus élégant que l’échantillonnage : PeerDAS ne s’est pas allumé à pleine capacité. Il s’est allumé à une capacité, puis on l’a monté avec les BPO forks — Blob Parameter Only (EIP-7892) — qui ne sont ni des hard forks coordonnés ni des mises à jour de client : ce sont des paramètres.
| Mise à niveau | Blobs cible | Blobs max |
|---|---|---|
| Cancun | 3 | 6 |
| Pectra (Prague) | 6 | 9 |
| Fusaka + BPO1 | 10 | 15 |
| BPO2 (7/1/2026) | 14 | 21 |
| BPO3 (ébauché) | 21 | 32 |
Du premier jour de Fusaka à aujourd’hui, le bloc est passé de 10 à 14 blobs de cible et de 15 à 21 de plafond : 1,75 Mio de cible et 2,6 Mio de maximum toutes les 12 secondes. Et tout cela sans que le réseau ait à se coordonner de nouveau, parce qu’on a séparé la capacité — la partie difficile, livrée une seule fois — de la quantité — la partie facile, qu’on tourne comme un bouton. Un EIP le dit avec une honnêteté qu’on ne voit pas souvent : les BPO « ne sont pas motivés par une demande démontrée, mais par le besoin d’évaluer les limites du système de façon contrôlée ».
C’est un laboratoire à l’échelle du mainnet, avec la main sur la vanne.
Un an sans problème, presque
Maintenant la partie où le titre de Vitalik mérite un léger ajustement. Ce ne sont pas presque douze mois : ce sont neuf mois et vingt-trois jours. Pendant ce temps, PeerDAS en tant que protocole n’a pas échoué une seule fois. Mais le réseau a eu ses journées.
Quelques jours après Fusaka, un bug dans Prysm v7.0.0 — un client de consensus — générait inutilement de vieux états en traitant des attestations en retard et mettait des nœuds hors de combat : au pic, environ un quart des validations du mainnet a cessé de participer et le réseau a frôlé la perte de finalité. Des mois plus tard, un livelock de synchronisation dans Lighthouse sur le testnet Hoodi bloquait la tête de chaîne tous les jours et demi, le limiteur de débit du nœud lui-même bloquant toutes les demandes de colonnes.
Aucun des deux n’était une défaillance de PeerDAS. Et c’est là le point, exactement celui que Vitalik salue : un protocole neuf qui traverse sa première année pendant qu’un client casse et que le réseau l’absorbe ne démontre pas de la mathématique. Il démontre de l’isolation des défaillances.
La diversité des clients est aux équipes de développement ce que PeerDAS est aux nœuds : que personne ne porte tout, pour que celui qui tombe n’emporte pas le réseau avec lui. C’est le même principe appliqué deux fois — dans la couche technique et dans la couche sociale — et c’est dans la seconde que cette année s’est vraiment gagnée. Un protocole s’écrit dans un EIP ; un écosystème qui encaisse un protocole neuf se construit pendant des années, et ça n’apparaît dans aucun tableau de métriques.
Le prix
La conséquence économique est celle qu’on voit déjà venir : si la disponibilité des données cesse d’être la ressource rare, l’offre de blockspace se multiplie et les frais des L2 chutent de plusieurs ordres de grandeur. Ethereum ne cherche pas à être la chaîne la plus rapide ; il cherche à être la couche de règlement la moins chère et la plus vérifiable. C’est là que cette année devient la base de tout le reste.
Il manque le plus gros
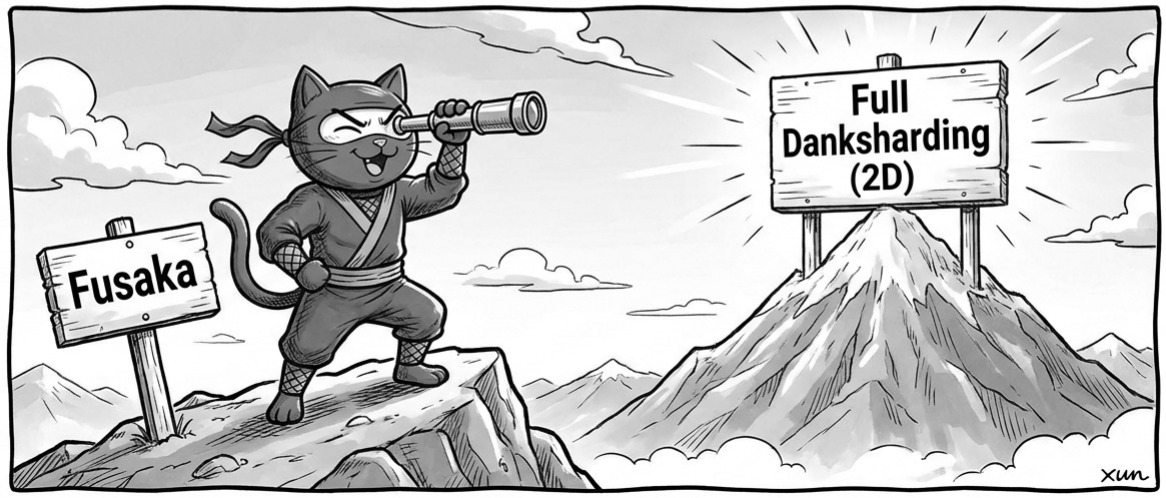
Les paramètres que le réseau fait tourner aujourd’hui sont ceux d’un échantillonnage 1D : une seule dimension de codage. La destination, c’est le danksharding complet, avec un codage en 2D — étendre non seulement les lignes mais aussi les colonnes — et 64 blobs ou plus par bloc.
La différence n’est pas cosmétique. En 2D, un nœud doit échantillonner bien moins de données pour atteindre le même niveau de certitude, et le travail du proposeur se répartit pour de bon. PeerDAS n’est pas la fin de la mise à l’échelle : c’est la preuve que la mathématique fonctionne en production, et cette preuve était la seule chose qui manquait pour autoriser le reste.
Data Available
Regardez la dernière planche de la série : le chat lâche le parchemin, le réseau respire, et la vignette entière se réduit à deux mots qui ne sont pas un cri de victoire mais une condition : Data Available.
Il vaut la peine de s’arrêter sur le type de certitude que PeerDAS achète. Ce n’est pas la certitude d’avoir tout vu. C’est la certitude que, s’il manquait quelque chose, le mensonge devrait survivre simultanément à chaque échantillon aléatoire que n’importe quel nœud décide de demander. C’est une certitude probabiliste, et c’est précisément pour ça qu’elle est bon marché à obtenir et bon marché à répéter à chaque slot.
Et c’est cela — et rien d’autre — le pont avec ce que nous écrivons ici. Hier, nous avons raconté comment Ğ1 décide qui est une personne avec une toile de confiance : il n’y a pas de registre central, il y a cinq signatures d’autres membres, et ces signatures expirent et doivent être renouvelées. Ğ1 non plus ne demande pas la vérité complète : elle demande une vérification locale, suffisante et renouvelable.
C’est le même geste épistémique dans deux couches différentes. PeerDAS : échantillonnez quelques cellules contre un engagement KZG. Ğ1 : vérifiez quelques signatures qui expirent. Dans aucun des deux cas la confiance ne se stocke : elle se produit, et se reproduit. Et dans aucun des deux cas il n’est nécessaire de tout détenir pour savoir que tout va bien.
Le siècle dernier nous a appris le contraire : pour faire confiance, il fallait avoir la copie, le registre, le notaire, la sauvegarde complète. Les engagements cryptographiques ont brisé cette équation. Une preuve n’est pas un fichier : elle n’occupe pas de place, ne se perd pas, peut être refaite à tout moment, et ne remet à personne les clés de votre maison.
C’est pourquoi cette année de PeerDAS est, au-delà d’un triomphe d’ingénierie, une leçon sur ce qu’est la liberté : ne pas dépendre de celui qui détient la copie. Pendant une décennie, la réponse à « est-ce que tout est disponible ? » était « télécharge le bloc entier et vérifie toi-même ». Aujourd’hui, la réponse est « échantillonne quelques cellules et sache ». C’est plus rapide, c’est moins cher, et c’est surtout plus ancien : c’est la façon dont la confiance a toujours fonctionné entre des personnes qui n’ont pas besoin de détenir toute la vérité pour savoir que l’autre est là.